

Nei primi anni Dieci, per gran parte dei ricercatori l’idea di un’intelligenza artificiale generale, un sistema in grado di fare quasi ogni cosa che fa una persona, era un’utopia o un delirio. Come ha scritto Kevin Roose, nel mondo accademico credere che fosse costruibile era “un tabù quanto dire di credere nell’alchimia”. Oggi, meno di un decennio dopo, ci sono milioni di utenti che ogni giorno usano ChatGPT o Claude per scrivere o programmare. Nei laboratori la domanda su che cosa stia succedendo è cambiata: non si chiede più quando arriverà l’AGI (acronimo di artificial general intelligence), ma se ci sia già.
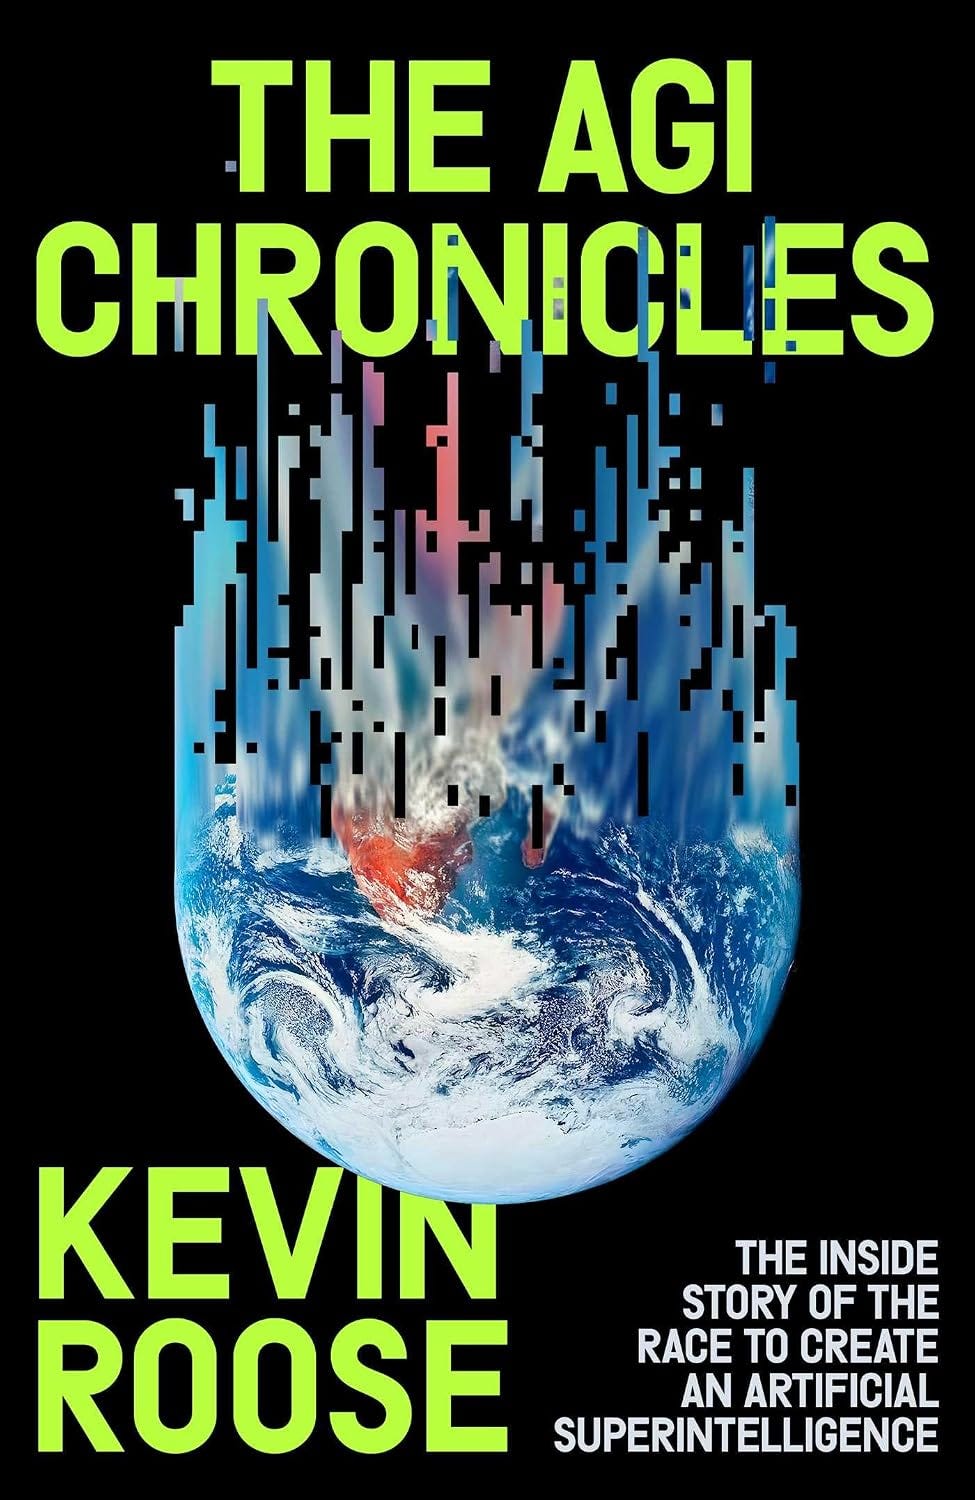
Dal 2017 al 2026 Kevin Roose è stato un giornalista di tecnologia del New York Times e nel suo nuovo libro The AGI Chronicles, pubblicato poche settimane fa negli Stati Uniti da Farrar, Straus and Giroux, Roose ha raccolto le fonti da più di 150 interviste a persone che lavorano o hanno lavorato in OpenAI, Anthropic e Google DeepMind, oltre a migliaia di pagine di documenti interni. Nell’ultimo capitolo, Roose sostiene che ogni passaggio decisivo, dall’architettura dei modelli attuali agli assistenti che programmano in autonomia, è stato inventato “da poche centinaia di persone”¹.
Il libro è diviso in tre parti. La prima parte, che copre il periodo circa tra il 2015 e il 2021, è quella che è più utile per chi, come me, si è interessato al tema solo dopo l’arrivo di ChatGPT. Qui si scoprono le idee, le scommesse e i conflitti che non sono visibili dall’esterno e che sono nati in pochi uffici tra San Francisco e Londra. La seconda e la terza parte invece partono dal novembre 2022, un periodo che è già in gran parte noto a chi ha seguito il dibattito.
Un’idea da eccentrici
Secondo Roose, all’inizio degli anni Dieci i convinti che l’AGI fosse raggiungibile erano solo alcune decine di persone, principalmente a San Francisco, con gruppi più piccoli a Londra e Toronto. La loro fiducia si basava sulla continua crescita della potenza di calcolo. A Toronto c’era Geoffrey Hinton, da decenni convinto del potenziale delle reti neurali. Queste reti, composte da strati di nodi collegati che si ispirano vagamente ai neuroni, sono in grado di imparare gli schemi dai dati, senza che un programmatore debba scrivere regole. Nel 2012 Ilya Sutskever e Alex Krizhevsky, due studenti di Hinton, vinsero nettamente la principale competizione di riconoscimento di immagini grazie ad AlexNet, una rete neurale a molti strati. Poco dopo vendettero la loro piccola società a Google per 44 milioni di dollari.
Nel 2010 a Londra nacque DeepMind, con Demis Hassabis, Shane Legg e Mustafa Suleyman come fondatori. La loro missione era quella di capire e riprodurre l’intelligenza, per poi applicarla a qualsiasi altro problema. Hassabis, ex bambino prodigio degli scacchi e con un dottorato in neuroscienze, puntò sui giochi e sull’apprendimento per rinforzo. Con l’apprendimento per rinforzo, un programma impara per prove ed errori, ricevendo un premio quando fa le mosse giuste e una penalità quando fa quelle sbagliate, come quando si addestra un cane. Nel 2014 Google acquistò DeepMind per 650 milioni di dollari. Nel 2016 AlphaGo, sviluppato da DeepMind, sconfisse Lee Sedol, diciotto volte campione del mondo di Go. Poi svilupparono AlphaGo Zero, che conoscendo solo le regole del gioco, imparava giocando contro se stesso. Dopo tre giorni, vinceva cento partite su cento contro la versione precedente. Il messaggio di DeepMind era chiaro: una macchina può superare le persone senza imparare da loro.
Nel dicembre 2015 nacque OpenAI, in parte come risposta a DeepMind e Google. Sam Altman, che all’epoca presiedeva Y Combinator, un incubatore di startup, scrisse in una lettera a Elon Musk che fermare lo sviluppo dell’AI era quasi certamente impossibile e che se doveva succedere comunque, era meglio che arrivasse prima “qualcuno diverso da Google”. Sutskever lasciò Google e divenne capo della ricerca di OpenAI. Per circa due anni OpenAI non ebbe una direzione chiara. A luglio 2017, Sutskever scrisse un’email a Musk, dove spiegava che mancavano ancora diverse idee fondamentali per l’AGI.
La parola successiva
Nell’estate del 2017 otto ricercatori di Google Brain pubblicarono l’articolo “Attention Is All You Need”, dove proponevano una nuova architettura di rete neurale: il transformer. Questa era l’idea che mancava a OpenAI. Fino a quel momento i sistemi leggevano il testo una parola alla volta, come attraverso una cannuccia. Il transformer invece elaborava l’intera frase in un colpo solo, permettendo a ogni parola di “vedere” le altre e al sistema di capire quali erano importanti per il significato della frase. Questo meccanismo era chiamato attenzione.
La portata di questa idea fu compresa da pochissime persone e il lavoro fu considerato un semplice progresso. Ma Sutskever capì subito che era importante e passò l’articolo ad Alec Radford, un ricercatore di 23 anni senza laurea. A dicembre del 2017 Radford addestrò un transformer su circa settemila romanzi autopubblicati. Addestrare significa far leggere i testi al modello e correggerlo ogni volta che commette un errore.
Fu così che nacque GPT, acronimo di generative pretrained transformer. “Generative” perché produce testo inedito e “pretrained” perché dopo un primo addestramento generale può essere adattato a compiti specifici senza dover essere riaddestrato da capo. Il compito di addestramento consisteva nel prevedere la parola successiva in una frase, un compito apparentemente semplice. Per esempio, Sutskever spiegava che se si legge l’ultima pagina di un giallo e il detective dice “il colpevole è…”, per indovinare il nome del colpevole bisogna conoscere la trama, le motivazioni dei personaggi e gli indizi presenti nei capitoli precedenti. Da qui Sutskever ragionò che un modello molto bravo a prevedere la parola successiva deve necessariamente farsi un’idea del mondo descritto dalle parole. Prevedere è quindi una forma di intelligenza superiore a quanto credeva la maggior parte dei ricercatori.
Il primo GPT era goffo, ma era in grado di svolgere compiti che non gli erano stati insegnati, come giudicare se una recensione fosse positiva o negativa o se una frase fosse grammaticalmente corretta. Queste capacità erano nate da sole dalla semplice previsione della parola successiva. L’articolo fu respinto dalla principale conferenza del settore, NeurIPS, e i colleghi di Radford iniziarono a chiedergli perché si stesse concentrando sui modelli linguistici (programmi che imparano dai testi a produrre testi) e non sull’apprendimento per rinforzo, come faceva DeepMind.
La scommessa sulle dimensioni
Dario Amodei è un fisico con un dottorato di Princeton che nel 2016 ha lasciato Google per entrare in OpenAI, dove ha sostenuto il lavoro di Radford. Nel 2017 Amodei ha scritto un documento interno, il Big Blob of Compute (in italiano “il grande ammasso di calcolo”), dove sosteneva che i progressi nei modelli di intelligenza artificiale derivano principalmente dalle dimensioni dei modelli. I tre fattori principali che determinano i progressi sono la potenza di calcolo (il numero di processori e il tempo di utilizzo), il numero di parametri (i valori numerici che il modello aggiusta durante l’addestramento) e la quantità di dati.
Amodei ha testato la sua tesi con GPT-2, utilizzando i dati raccolti da circa otto milioni di link di Reddit e moltiplicando il calcolo per dieci rispetto al GPT originale. Alla fine del 2018, GPT-2 era in grado di scrivere racconti e articoli di giornale inventati ma credibili, nonostante fosse stato addestrato solo a prevedere le parole. Il gruppo di Amodei dedicato alla sicurezza temeva che potesse essere usato per la disinformazione su larga scala e OpenAI decise di pubblicare solo una versione ridotta. Il risultato più importante fu che quattro versioni di GPT-2 di dimensioni diverse mostravano che la più grande migliorava rispetto alle altre esattamente come previsto in precedenza. Amodei ha detto che era “come in una simulazione”.
A gennaio 2020 Jared Kaplan e Sam McCandlish, due fisici del gruppo di Amodei, hanno pubblicato l’articolo sulle leggi di scala, con le formule che collegano le risorse di addestramento e la qualità del modello. In breve, con più risorse si ottiene un miglioramento prevedibile in anticipo, come se fosse un fenomeno fisico. L’articolo è stato quasi ignorato perché il mondo era concentrato su un’altra curva esponenziale: quella della pandemia di Covid-19. Pochi mesi dopo è arrivato GPT-3, con 175 miliardi di parametri e un calcolo circa mille volte superiore a GPT-2. GPT-3, con due o tre esempi di un compito, è in grado di eseguirlo senza un addestramento specifico.
Amodei è stato a capo dello sviluppo di GPT-2 e GPT-3 e i due articoli fondamentali sui grandi modelli linguistici, quello sulle leggi di scala e quello su GPT-3, hanno Amodei come ultimo autore, posizione che di solito viene data a chi dirige il lavoro. Amodei è la persona a cui si deve l’idea che i modelli diventano più intelligenti semplicemente diventando più grandi. Nel 2019 Amodei ha scritto un piano riservato verso l’AGI che prevedeva di addestrare un modello linguistico su tutto il testo disponibile, magari anche immagini e video, di usare l’apprendimento per rinforzo per la matematica e la programmazione e infine di far costruire al modello un modello migliore. I tempi erano troppo ottimisti, ma la sequenza dei passi è quella che è realmente avvenuta.
Da modello ad assistente
GPT-3 era in grado di scrivere testi fluidi, ma inventava fatti e non seguiva bene le richieste. Questo perché era stato addestrato a proseguire qualsiasi testo, mentre rispondere alle domande di una persona è un compito diverso. La soluzione, proposta dal gruppo di Amodei e in particolar modo da Paul Christiano, è stata l’utilizzo della tecnica del RLHF (reinforcement learning from human feedback), ossia l’apprendimento per rinforzo guidato dai giudizi umani. Christiano ci lavorava da anni. In pratica, si fa generare al modello diverse risposte alla stessa domanda e poi si chiede a delle persone di classificarle dalla migliore alla peggiore. Con questi giudizi si addestra un secondo modello che impara a prevedere quali sono le risposte preferite. Questo secondo modello valuta poi le risposte del primo e lo premia quando risponde come vorrebbero le persone.
Il significato di questo approccio è stato la prima unione di due filoni di ricerca fino a quel momento separati: le capacità di scrittura dei modelli linguistici e il metodo di rinforzo usato da DeepMind. ChatGPT è nato addestrando un modello linguistico con la tecnica del RLHF per farlo diventare un assistente.
Tra il 2021 e il 2022 OpenAI e DeepMind hanno scoperto in modo indipendente un errore di proporzioni nelle leggi di scala. A parità di calcolo, è meglio aumentare sia le dimensioni del modello sia la quantità di testo, mentre prima si tendeva a privilegiare le dimensioni. Come ha scritto Roose, l’intero settore aveva dato ai modelli solo una frazione dei dati necessari, lasciandoli affamati. GPT-4 è stato addestrato con un calcolo circa cento volte quello di GPT-3 e l’addestramento è stato concluso nell’estate 2022. All’inizio sembrava un fallimento costoso, ma una volta corretti gli errori della rifinitura finale, la fase che rende il modello utilizzabile, ha iniziato a superare gli esami di abilitazione professionale di medici e avvocati.
Perché Google è arrivata dopo
Google è l’autrice del transformer, è proprietaria di DeepMind e di Google Brain, progetta i propri processori per l’AI e ha molti dei migliori ricercatori al mondo nel suo team. Nel 2019 Richard Sutton, tra i fondatori dell’apprendimento per rinforzo, ha pubblicato il saggio breve intitolato “The Bitter Lesson” (la lezione amara). In esso, Sutton sosteneva che in settant’anni di ricerca i metodi generali che sfruttano la potenza di calcolo hanno sempre prevalso su quelli costruiti a mano dagli esperti. OpenAI stava già seguendo questa lezione, Google no.
Google Brain, guidato da Jeff Dean, aveva una cultura universitaria e dava molta libertà di ricerca ai suoi ricercatori. Uno di loro ha raccontato che l’attenzione alle applicazioni commerciali era praticamente assente, in modo quasi maniacale. Noam Shazeer, tra gli autori del transformer, era uno dei pochi convinti che la strada da seguire fosse quella di costruire modelli sempre più grandi. Nel 2020 Shazeer e Daniel De Freitas hanno creato un chatbot chiamato Meena, che ogni giorno veniva usato da 80 mila dipendenti. In un memo, i due hanno scritto che un sistema simile avrebbe potuto sostituire il motore di ricerca. Ma l’ufficio legale e i responsabili della ricerca hanno bloccato il progetto. Shazeer e De Freitas hanno poi lasciato Google e fondato Character.AI (una startup di chatbot che interpretano personaggi).
Il rischio per Google era che il motore di ricerca vive della fiducia nella correttezza delle informazioni e un modello che inventa risposte lo avrebbe messo in pericolo. Come ha scritto Roose, in Google i dirigenti venivano raramente puniti se fermavano un lancio ritenuto rischioso. Era un caso tipico del dilemma dell’innovatore, cioè la situazione in cui un leader di mercato si trova di fronte a una novità in grado di cannibalizzare il prodotto da cui vive. Google ha scelto di difendere il prodotto esistente.
DeepMind era ancora concentrata sull’apprendimento per rinforzo. Secondo Hassabis, GPT-2 sapeva solo parlare. Nel 2020 AlphaFold ha di fatto risolto il problema della previsione della forma delle proteine, il più grande risultato scientifico di DeepMind (che ha portato a Hassabis il Nobel per la chimica nel 2024). Sui modelli linguistici DeepMind era in ritardo. Anni dopo, Hassabis ha detto a Roose che il suo errore, insieme a quello di Google Brain, fu non essersi concentrati prima e con più convinzione sui modelli più grandi.
I soldi e la scissione di Amodei
Con modelli sempre più grandi, i costi sono aumentati. Nei primi due anni Musk ha dato 38 milioni di dollari a OpenAI, ma nel 2017 ha chiesto di guidare una nuova società for profit e di avere la maggioranza delle azioni. Sutskever e Greg Brockman hanno risposto che in questo modo Musk avrebbe avuto il controllo assoluto sull’AGI. A inizio 2018 Musk è uscito dal consiglio di amministrazione. Altman ha creato allora una società a scopo di lucro sotto il controllo dell’ente non profit, con i guadagni degli investitori limitati a cento volte l’investimento. Nel 2019 Microsoft, dopo aver visto GPT-2 in una presentazione ai suoi dirigenti, ha investito un miliardo di dollari.
Amodei ha perso sempre più fiducia nei vertici di OpenAI. Ha rotto con Brockman, prima suo amico, e il suo rapporto con Altman è diventato ancora peggiore. Amodei ha elencato una serie di episodi in cui si è sentito ingannato. Non aveva dimenticato un piano del 2017, che secondo OpenAI fu solo accennato, per vendere ai governi, anche Cina e Russia, i diritti sulla tecnologia futura. Come ha scritto Roose, singoli episodi non erano sufficienti per andarsene, ma messi insieme facevano di Altman, agli occhi di Amodei, una persona inaffidabile per una tecnologia di questo tipo. Kaplan ha proposto di creare una nuova azienda per continuare la ricerca sui modelli sempre più grandi, ma con la sicurezza come priorità. La sicurezza riguarda la ricerca su come evitare danni e la perdita di controllo da parte di chi costruisce i sistemi.
A dicembre 2020 Amodei è uscito da OpenAI insieme a sei cofondatori, tra cui Daniela Amodei (sua sorella), Kaplan, Tom Brown e Chris Olah. Hanno portato via gran parte delle conoscenze di OpenAI sulle leggi di scala e sull’addestramento di GPT-3. Hanno fondato Anthropic, una società a beneficio pubblico: si tratta di una forma giuridica americana che obbliga a perseguire una missione insieme al profitto. L’idea di partenza era che i sistemi molto potenti sarebbero arrivati in ogni caso e che un’organizzazione attenta alla sicurezza dovesse stare in prima linea per influenzare il settore.
Il primo Claude era pronto a inizio 2022, quasi dieci mesi prima di ChatGPT, ma non fu rilasciato perché all’inizio in Anthropic vendere prodotti era quasi una parolaccia. Dopo ChatGPT, Amodei disse ai colleghi che non rilasciarlo significava lasciare la frontiera a chi teneva meno alla sicurezza e che un prodotto ben protetto avrebbe spinto anche gli altri a migliorare. Amodei chiamava questa idea una corsa verso l’alto. E il risultato è stato che il laboratorio nato da una scissione per la sicurezza è diventato uno dei tre principali concorrenti.
Roose classifica i protagonisti in tre famiglie. Da un lato ci sono gli scienziati, come Hassabis, che vedono l’AGI come la sfida tecnica suprema. Dall’altro lato ci sono i cercatori, come Altman, che vedono l’AGI come una svolta nella storia della vita. E infine ci sono i sopravvissuti, come Amodei, che vedono l’AGI come un asteroide in arrivo sulla Terra. Nel 2022 tutti e tre i gruppi hanno concluso che conta soprattutto la velocità. Come dice Roose, “Qualunque cosa credessi, finivi per accelerare”.
Dopo ChatGPT e come i modelli hanno imparato a “ragionare”
Il 30 novembre 2022 OpenAI rilasciò ChatGPT come una sorta di “anteprima di ricerca in sordina”, senza annunci e con basse aspettative di interesse. Il modello alla base era GPT-3.5 (una versione migliorata di GPT-3), già disponibile per gli sviluppatori da mesi e quasi del tutto ignorato. In cinque giorni raggiunse un milione di utenti. I laboratori ne trassero due lezioni: da un lato, il pubblico sapeva molto poco dei progressi fatti in segreto per anni; dall’altro lato, la presentazione, una semplice chat gratuita, valeva quanto il modello stesso.
Nella seconda e terza parte del libro vediamo Google che dichiara codice rosso, il licenziamento improvviso di Altman nel novembre 2023 e il suo ritorno pochi giorni dopo, il caso DeepSeek, la corsa ai data center e il successo di Claude Code, il programma di Anthropic che scrive e corregge codice in autonomia. Questi episodi sono in gran parte noti a chi segue le notizie, ma qui torna la tesi del libro. Secondo una stima riportata da Roose, forse in tutto il mondo c’erano solo cinquanta persone capaci di addestrare modelli alla scala massima. Anche per questo nel 2024 Google spese 2,7 miliardi di dollari per far rientrare Shazeer.
Fino al 2023, i modelli linguistici avevano un limite strutturale: generavano una parola dopo l’altra, senza la possibilità di tornare indietro e correggerle. Come ha distinto lo psicologo Daniel Kahneman, erano bravissimi nel pensiero veloce e istintivo (dare risposte senza riflettere), ma non nel pensiero lento e deliberato (risolvere problemi di matematica o progettare un programma).
In secondo luogo, i testi di qualità su internet si erano quasi esauriti, rendendo sempre più difficile far crescere i modelli con più dati. Nel 2020, un inedito memo di Sutskever spiegava come far progredire i modelli senza nuovi testi, ispirandosi a quanto fatto con AlphaZero. L’idea è stata sviluppata da un ristretto gruppo di persone in OpenAI, guidate da Jakub Pachocki e Szymon Sidor.
Il metodo si basa su due passaggi. Nel primo, il modello scrive il proprio ragionamento in una sorta di blocco note nascosto prima di dare una risposta (in inglese chain of thought, catena di pensiero). Nel secondo passaggio, si applica l’apprendimento per rinforzo a queste catene, come fatto con AlphaZero nel Go. Un modello valutatore giudica ogni tentativo e premia i passaggi che portano alla risposta corretta, penalizzando quelli che si allontanano. Nell’autunno del 2023, un modello sperimentale addestrato in questo modo, Q*, ha iniziato a correggersi da solo nei problemi di matematica. La scoperta aggiunge un quarto ingrediente, accanto ai tre delle leggi di scala (calcolo, dati e parametri dell’addestramento). Il quarto ingrediente è il calcolo che viene usato al momento della risposta: il modello ragiona più a lungo e più tempo ha a disposizione, migliori sono le risposte. È applicabile ai modelli esistenti e non richiede nuovi testi, risolvendo il problema dei dati finiti.
Il 12 settembre 2024 è uscito il modello con il nome di o1, molto forte nei campi dove le risposte sono verificabili, come la matematica e la programmazione, ma nella scrittura creativa era al livello dei modelli precedenti. La reazione del pubblico è stata fredda, ma i concorrenti hanno subito capito che era importante. Gli specialisti di DeepMind in rinforzo avevano provato a portare questa idea sui modelli linguistici senza successo e Hassabis mise DeepMind al lavoro per recuperare. In pochi mesi Google presentò il suo primo modello che ragiona e la cinese DeepSeek ne pubblicò una versione scaricabile liberamente. Questo è significativo perché unisce le due strade del 2017 che erano considerate alternative: il linguaggio umano compresso dentro i modelli (OpenAI) e l’apprendimento per rinforzo (la vittoria di DeepMind a Go). È anche il passo previsto dal piano di Amodei.
Una storia che poteva andare diversamente
In breve: l’attuale AI è nata da una serie di scelte precise di un ristretto gruppo di persone che si conoscevano quasi tutte e a volte vivevano insieme. Come dice esplicitamente Roose, se si fossero dedicati agli aerei supersonici o all’agricoltura rigenerativa, oggi probabilmente non avremmo nessuno di questi chatbot e l’AI sarebbe ancora considerata come un algoritmo di raccomandazione su cosa guardare.
Le motivazioni per puntare sul campo sono state diverse, dalla salvezza dell’umanità alla vittoria sulla Cina, dalla cura delle malattie al voler arrivare prima di Google, ma secondo Roose, la vera motivazione, profonda e poco dichiarata, è quella che Oppenheimer ha raccontato sulla bomba atomica: quando si è di fronte a qualcosa di tecnicamente affascinante, lo si fa e solo dopo si discute del suo utilizzo. Vedere sistemi che imparano a scrivere e a ragionare è semplicemente troppo emozionante per fermarsi, anche per chi temeva le conseguenze.
Per chi si è avvicinato all’AI con l’arrivo di ChatGPT, la prima parte del libro permette di conoscere la storia che manca, ossia quando le idee alla base degli strumenti che usiamo ormai ogni giorno erano scommesse di pochi considerati un po’ matti. Aiuta anche a capire il comportamento attuale delle aziende, la nascita di Anthropic da una scissione, il ritardo e la rincorsa di Google. La seconda parte del libro contiene invece fatti già passati in buona parte dai giornali, ma è utile per rimetterli in ordine.
Il libro è al momento solo disponibile in inglese e si può comprare qui.
Per un po’, basta articoli sull’intelligenza artificiale. Il prossimo libro di cui potremmo parlare è The Making Of The Atomic Bomb di Richard Rodes che sto leggendo in questi giorni (su Goodreads tengo traccia di tutte le letture).